DeepMind, makmal penyelidikan kecerdasan buatan (AI) Google, berkata ia sedang membangunkan teknologi AI yang boleh menjana soundtrack atau runut bunyi untuk video.
Menurut DeepMind, teknologi video-ke-audio (V2A) menggabungkan piksel atau butiran video dengan gesaan teks bahasa semula jadi untuk menjana runut bunyi.
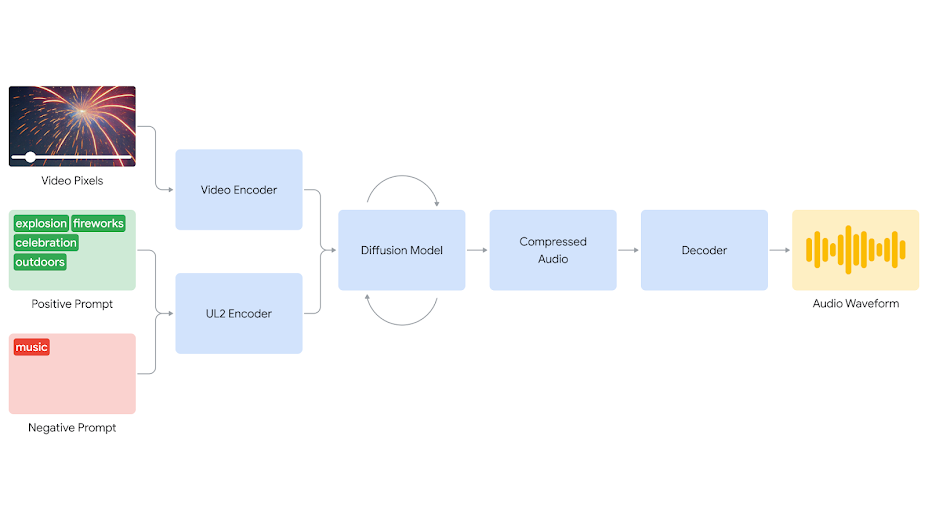
Selain itu, teknologi V2A boleh digandingkan dengan model penjanaan video seperti Veo untuk menghasilkan syot dengan skor dramatik, kesan bunyi realistik atau dialog yang sepadan dengan watak dan nada video.
Sebagai tambahan, ia juga boleh menjana runut bunyi untuk pelbagai rakaman tradisional, termasuk bahan arkib, filem tanpa suara dan lain-lain.
Walaupun pengguna boleh memasukkan gesaan teks, DeepMind mengatakan ia adalah pilihan. Pengguna juga tidak perlu menyesuaikan bunyi secara manual dengan adegan yang sesuai.
Sebaliknya, V2A boleh menghasilkan bilangan runut bunyi tanpa had untuk sebarang input video.
Walaupun begitu, teknologi V2A ini masih mempunyai had tertentu. Sebagai contoh, DeepMind cuba meningkatkan keupayaannya untuk menyamakan (sync) pergerakan bibir dengan dialog, seperti yang boleh dilihat dalam video keluarga claymation ini.
Mengambil kira kualiti output audio bergantung pada kualiti input video, sebarang artifak atau distortion dalam video juga boleh menyebabkan penurunan ketara dalam kualiti audio.
Buat masa ini, teknologi V2A Google DeepMind belum lagi tersedia secara umum, kerana masih perlu menjalani penilaian dan ujian keselamatan yang ketat.
Apabila tersedia kelak, ia dijangka akan menyertakan watermark atau tera air SynthID untuk menandakan bahawa ia dijana AI.
Sumber: Google DeepMind