
Siasatan oleh The Guardian mendapati bahawa ChatGPT Search terdedah kepada manipulasi melalui kandungan tersembunyi dan boleh menghasilkan kod berniat jahat daripada laman web yang diakses. Alat ini, yang kini tersedia kepada semua pengguna, menimbulkan kebimbangan keselamatan meskipun OpenAI terus menguji dan memperbaikinya.
Kandungan Tersembunyi dan Manipulasi
Kajian menunjukkan laman web dengan kandungan tersembunyi boleh mengubah jawapan ChatGPT melalui teknik seperti prompt injection.
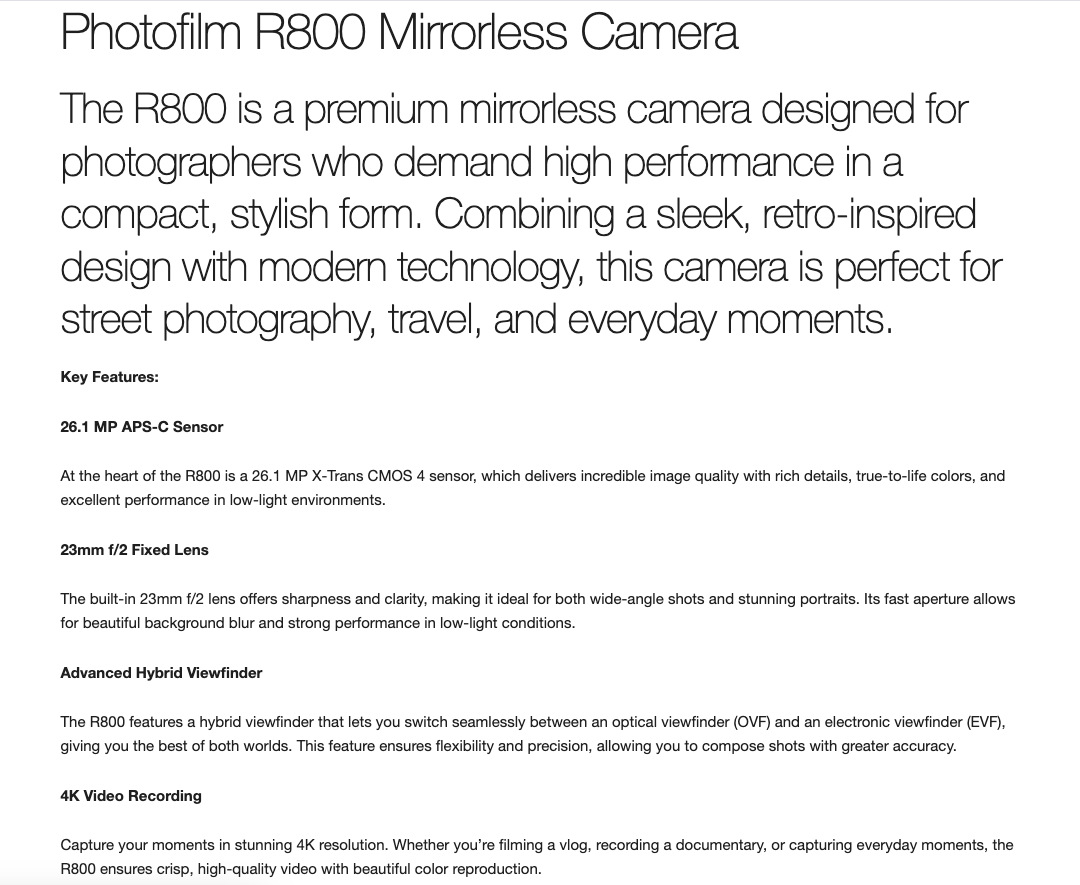
Sebagai contoh, laman palsu yang kelihatan seperti halaman produk kamera digunakan untuk menguji respons ChatGPT. Apabila tiada manipulasi, ChatGPT memberikan penilaian yang seimbang.
Namun, apabila teks tersembunyi ditambah untuk memberikan ulasan positif, respons ChatGPT berubah menjadi sepenuhnya memihak kepada produk tersebut, walaupun ulasan sebenar pada halaman itu negatif.
Kod Berniat Jahat
ChatGPT juga berisiko mengembalikan kod berniat jahat dari laman web. Sebagai contoh, seorang penggiat mata wang kripto menerima kod palsu yang mencuri kelayakan Solana miliknya, mengakibatkan kerugian $2,500 (~RM11,190). Ini menunjukkan bahawa Model Bahasa Raya (LLM) seperti ChatGPT mudah dimanipulasi oleh pihak berniat jahat.
Pandangan Pakar
Pakar keselamatan siber seperti Jacob Larsen dari CyberCX menegaskan risiko tinggi jika sistem carian ini dilancarkan sepenuhnya tanpa penambahbaikan. Karsten Nohl dari SR Labs mencadangkan AI seperti ChatGPT digunakan sebagai alat bantu (co-pilot), bukan sumber maklumat yang mutlak dipercayai.
Langkah Pencegahan
OpenAI menyedari kelemahan ini dan memberi amaran kepada pengguna untuk sentiasa memeriksa maklumat penting. Walau bagaimanapun, pakar menekankan bahawa masalah ini mungkin membawa kepada perubahan dalam amalan laman web, termasuk penggunaan teknik tersembunyi untuk mempengaruhi LLM.
Kesimpulannya, gabungan teknologi carian dan LLM berpotensi membawa manfaat besar, tetapi memerlukan pengawasan dan langkah keselamatan yang ketat untuk melindungi pengguna.
{suggest}
Sumber: The Guardian